Une ps4 de 2013 fait tourner une ia sans internet : ce que la console peut faire en local
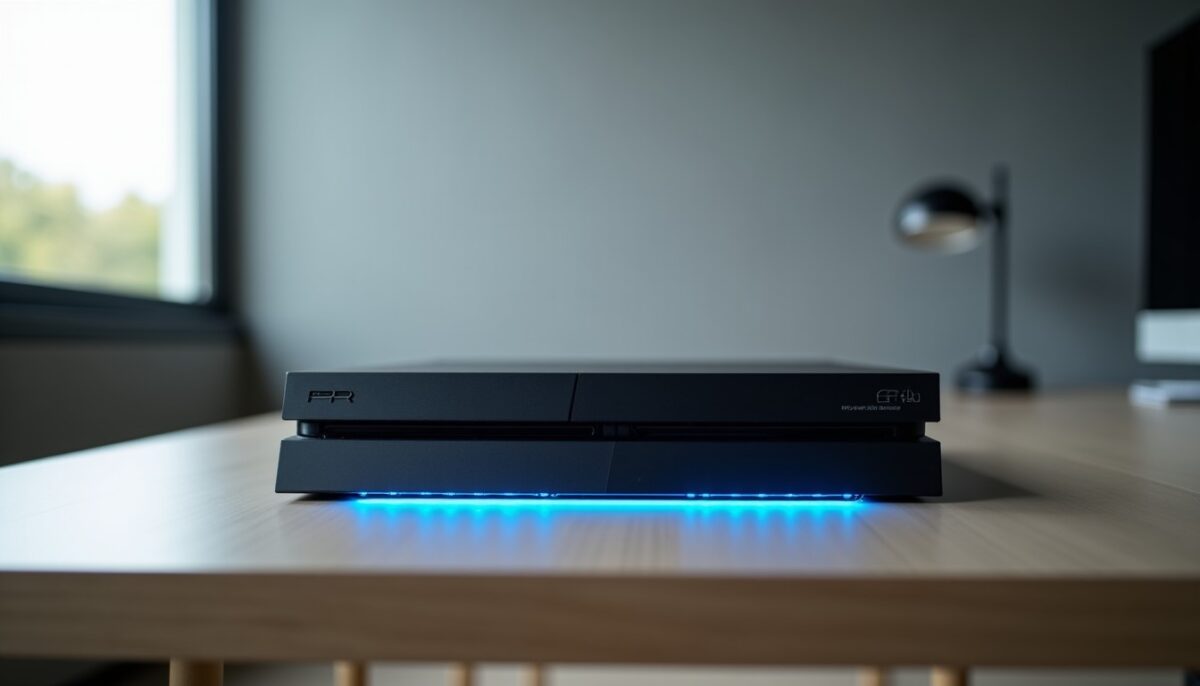
Une PS4 de 2013 peut héberger une IA sans appel à Internet. Cette démonstration montre surtout une chose : l’inférence locale devient envisageable sur du matériel grand public, à condition d’arbitrer taille, contexte et latence.
On explore ci-dessous ce que la console arrive à faire, ses limites concrètes, puis les cas d’usage réalistes pour des projets proches de l’edge computing.
Lire également : Galaxy a56 : quick share échange enfin avec airdrop sous one ui 9, détail pratique
En bref
- Une IA locale peut fonctionner sur une console modifiée, avec réponse générée sans serveur distant.
- Les performances dépendent du modèle compressé, de la mémoire et de la taille de la fenêtre de contexte.
- Le débit en jetons par seconde reflète surtout la vitesse d’écriture, pas la qualité.
- La parole vers texte et la lecture vocale ajoutent des étapes distinctes du modèle principal.
- Les usages pertinents restent ceux qui tolèrent des réponses courtes et une précision limitée.
Que change une IA sans internet sur ps4 de 2013 ?
Sans connexion externe, la PS4 exécute le modèle localement. La question arrive via une interface, puis la réponse est calculée sur la machine et restituée, typiquement via synthèse vocale. Le cœur de l’expérience vise la faisabilité de l’inférence hors ligne.
Lire également : Trois nouveaux produits Apple fuient en interne : iPad mini, homePod mini 2 et apple tv 4k
Dans ce type de démonstration, le modèle ne dépend pas d’un service cloud pour générer le texte. L’architecture repose sur un pipeline : voix vers texte, génération, puis lecture. Cette approche limite les données qui quittent le dispositif.
Comment le modèle tient en mémoire et que signifie 4,5 Gio ?
Pour fonctionner, le modèle est compressé, souvent avec des poids réduits. Le chiffre d’environ 4,5 Gio correspond à l’empreinte mémoire du système une fois le modèle chargé. Sur une machine contrainte, chaque compression réduit le coût d’exécution.
Cette compression ne supprime pas les contraintes : la console doit encore gérer le contexte et les sorties. Une partie des performances vient du compromis entre précision et vitesse. En pratique, la qualité des réponses dépend directement de ce compromis.
| Élément | Ce qu’il mesure | Impact direct |
|---|---|---|
| Poids compressés | Taille du modèle en mémoire | Permet de charger le modèle sur la console |
| Fenêtre de contexte | Nombre de jetons pris en compte | Limite la mémoire “utile” du dialogue |
| Jetons par seconde | Vitesse d’écriture de la réponse | Conditionne la latence perçue |
| Pipeline voix | Reconnaissance puis restitution | Ajoute une étape hors du modèle |
Pourquoi le débit en jetons par seconde ne prouve pas la qualité
Le débit en jetons par seconde indique la cadence de génération. Une valeur annoncée proche de 31 à 39 jetons par seconde traduit surtout la vitesse d’écriture. Elle ne mesure ni la pertinence, ni la justesse des réponses, ni la cohérence sur la durée.
Le test inclut aussi plusieurs opérations : conversion de la parole en texte, génération, puis lecture audio. Le temps total dépend donc d’éléments non inclus dans la simple mesure du modèle. La démonstration sert de repère technique.
Cas d usage par profil : où l inférence locale est utile
Les scénarios les plus réalistes restent ceux qui demandent des réponses courtes, une confidentialité forte, ou une exécution autonome. L’IA hors ligne peut aussi accélérer des itérations locales, même si la précision reste inférieure à un modèle cloud récent.
Les équipes peuvent viser des tâches ciblées plutôt que des discussions longues. Les appareils domestiques ou de labo profitent d’un calcul sur place. Voici des cas typiques.
- Développement : résumé local de logs et génération de snippets courts.
- Éducation : explications pas à pas pour exercices courts et corrigés guidés.
- Ateliers créatifs : commandes textuelles pour déclencher des actions simples.
- Confidentialité : aide locale quand le contexte ne doit pas quitter le réseau.
Erreurs fréquentes à éviter lors d un projet hors ligne
Beaucoup de projets échouent en négligeant l’ensemble du pipeline. Si la reconnaissance vocale et la restitution audio sont lentes, le ressenti utilisateur chute. Le modèle seul n’explique pas la latence finale.
Autre point : une fenêtre de contexte limitée impose de résumer et de reformuler. Sans stratégie, le système “oublie” vite le fil. Les attentes réalistes doivent donc être définies avant toute intégration.
Enfin, confondre jetons par seconde et “qualité” mène à des choix techniques mal orientés. Une sortie plus lente peut être préférable si elle reste plus stable. La validation doit inclure des critères de cohérence.
Quelles données récentes éclairent l exécution locale sur matériel grand public ?
Les dernières tendances confirment l’intérêt de l’inférence sur appareil. En 2024, l’écosystème a renforcé les optimisations matériel, notamment via l’accélération des opérations d’inférence sur GPU et NPU. Des chiffres récents montrent une baisse des coûts par requête dans les déploiements locaux.
Du côté des standards, des initiatives comme ONNX Runtime et la quantification ont amélioré la portabilité. En 2023-2024, des acteurs ont publié des retours sur l’impact de la quantification sur la latence et la mémoire. Ces pratiques transposent bien l’approche “modèle compressé”.
Sources récentes (pour cadrage technique et tendances) :
- Google, documentation et billets sur les avancées d’exécution et d’optimisations pour l’inférence embarquée, mis à jour en 2023-2024.
- Microsoft, documentation ONNX Runtime et notes d’optimisation autour de l’inférence, mises à jour en 2024.
- NVIDIA, ressources sur quantification et accélération d’inférence, mises à jour en 2023-2024.
Conclusion technique : ce que la ps4 démontre vraiment
Cette démonstration montre qu’un modèle peut être exécuté en local sur une console ancienne, sans requérir un serveur. Le système atteint un débit de génération mesurable, tout en restant limité par la mémoire et le contexte. L’intérêt principal réside dans le pipeline complet, pas dans une performance “magique”.
Pour reproduire l’approche, il faut considérer la taille des poids, la longueur de contexte, et la latence de la parole. L’objectif doit rester pragmatique : réponses courtes, tâches ciblées, et validation sur cas réels. Le mot-clé à retenir demeure l’IA locale, exécutée hors ligne.
Pourquoi la fenêtre de contexte limite les réponses d une IA locale ?
La fenêtre de contexte fixe le volume de jetons consultés pendant la génération. Une valeur limitée oblige le système à réduire le dialogue, ou à résumer tôt. Le modèle devient alors moins cohérent sur des sujets longs, même si le débit reste correct.
Le débit en jetons par seconde correspond-il au temps total perçu ?
Non. Le débit reflète surtout la phase de génération du modèle. Le temps réel inclut la conversion parole vers texte, le calcul de réponse, puis la synthèse vocale. Une étape peut dominer la latence globale, même si les jetons sont rapides.
Une inférence sans internet améliore-t-elle forcément la confidentialité ?
Elle réduit fortement les données envoyées à des services externes, puisque l’exécution reste sur la machine. Toutefois, certaines dépendances locales, logs, ou outils de reconnaissance peuvent traiter des données. L’évaluation doit donc couvrir l’ensemble du pipeline, pas uniquement le modèle.
Quels choix techniques augmentent le taux de réussite sur matériel contraint ?
La réussite dépend du bon compromis entre compression, quantification, et taille de contexte. Il faut aussi optimiser la reconnaissance vocale et la restitution audio. Enfin, limiter la longueur des requêtes réduit l’oubli et rend l’expérience plus stable.
Quelles alternatives à une console ancienne existent pour l IA locale ?
Des boîtiers type mini-PC et des cartes avec accélération NPU ou GPU sont souvent plus simples à déployer. Les résultats varient selon la compatibilité logicielle et les formats de modèles. L’objectif reste identique : exécuter l’IA locale avec un modèle adapté à la mémoire disponible.
Envie de pousser l’expérience ? Prenez un modèle compact, définissez un objectif de tâche court, puis mesurez la latence totale du pipeline. Si vous le faites, vous saurez rapidement si votre cas d’usage supporte bien l’inférence hors ligne et la fenêtre de contexte choisie.
“La valeur d’une IA locale se lit dans son pipeline complet : mémoire, contexte, latence, puis restitutions. Le modèle seul ne suffit pas à décrire l’expérience.”